PCI Express(PCIe)는 CPU·칩셋과 그래픽카드, NVMe SSD, 네트워크 카드 같은 장치를 잇는 고속 직렬 인터페이스다. 과거 PCI는 여러 장치가 하나의 병렬 버스를 나누어 썼지만, PCIe는 두 장치 사이에 점대점 링크를 만든다. 연결된 장치마다 링크가 따로 있으므로 서로 다른 속도와 폭으로 통신할 수 있다.
링크 구성
- Lane
- 송신용 차동쌍과 수신용 차동쌍으로 이루어져 동시에 주고받는다
- 폭
- 묶으면 x1·x2·x4·x8·x16 링크가 된다
- 동작 폭
- x16 슬롯에 x4 카드는 x4로, 슬롯이 x16이어도 배선이 x4면 x4에 머문다
세대와 처리량
- 세대 숫자
- Lane 하나가 보낼 수 있는 신호 속도를 뜻한다
- 환산
- GT/s와 부호화 비율, Lane 수를 함께 봐야 GB/s가 된다
- 6.0
- PAM4와 고정 크기 FLIT, FEC·CRC로 전송 단위와 오류 처리가 바뀐다
- 양방향
- PCIe 6.0 x16 최대 256GB/s, 7.0 최대 512GB/s는 각각 양방향 합계다
실제 동작
- 하위 호환
- 양쪽이 함께 지원하는 세대와 폭으로 내려간다
- 라이저
- 긴 라이저와 기판 배선은 신호 여유를 줄여 링크 하향이나 오류를 만들 수 있다
- NVMe
- 보통 x4를 쓰며 여러 SSD가 칩셋 업링크를 공유하면 그 경로가 병목이 된다
Lane과 링크
Lane 하나에는 송신용 차동쌍과 수신용 차동쌍이 있다. 서로 다른 방향의 경로가 나뉘어 있으므로 송신과 수신을 동시에 진행할 수 있다. 여러 Lane을 묶으면 x1·x2·x4·x8·x16 같은 넓은 링크가 된다. x16 슬롯에 x4 카드가 동작하는 것은 양쪽이 공통으로 지원하는 x4 폭에서 멈추기 때문이다. 반대로 물리적인 슬롯 길이가 x16이어도 메인보드 배선이 x4까지만 이어지면 실제 링크도 x4에 머문다.
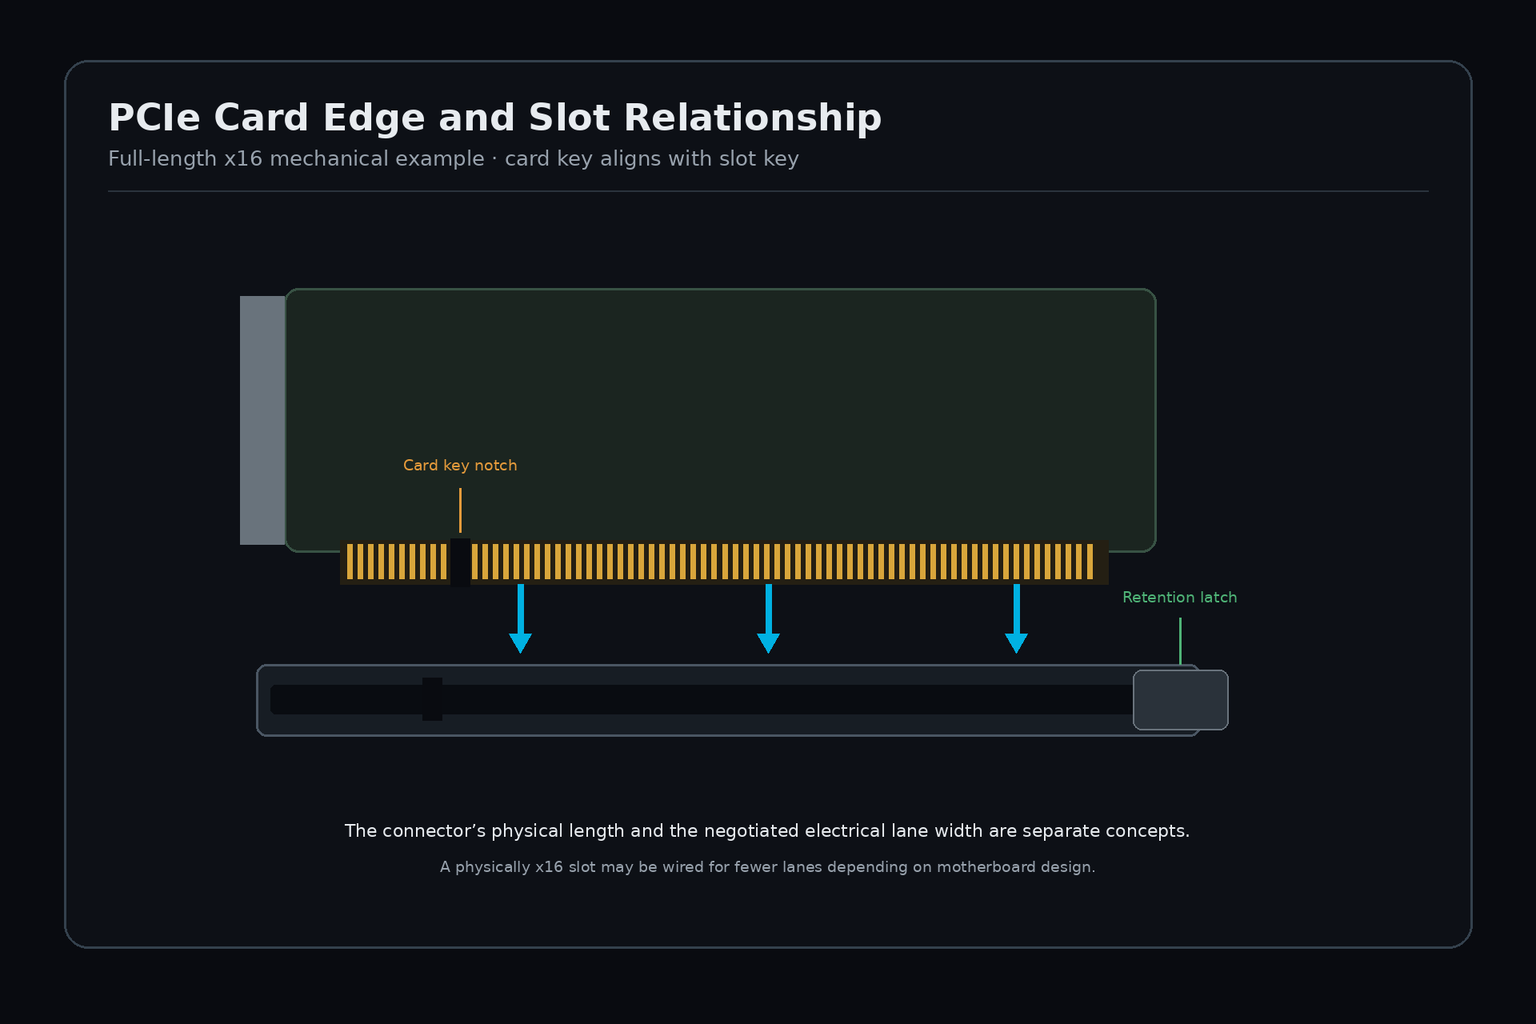
카드 엣지 커넥터의 키 홈과 슬롯의 키, 끝단 래치가 맞물리는 구조를 보여 주는 개념도다. 세대별 Lane 수를 나타내지는 않는다.
세대 숫자는 Lane 하나가 보낼 수 있는 신호 속도를 뜻한다. 아래 표는 한 방향의 대역폭을 비교한다. 15세대 값은 선로 부호화 손실을 제외한 값이며, 67세대 값은 FLIT·FEC 등 오버헤드를 제외하기 전 원시 대역폭이므로 같은 의미의 payload 수치가 아니다. 패킷 헤더와 흐름 제어, 다른 프로토콜 처리까지 포함한 실제 응용 프로그램 처리량은 이 값보다 낮게 나타날 수 있다.
| 세대 | 신호 속도 | 부호화 | Lane당 한 방향 | x16 한 방향 |
|---|---|---|---|---|
| PCIe 1.x | 2.5 GT/s | 8b/10b | 0.25 GB/s | 4 GB/s |
| PCIe 2.x | 5.0 GT/s | 8b/10b | 0.50 GB/s | 8 GB/s |
| PCIe 3.x | 8.0 GT/s | 128b/130b | 약 0.985 GB/s | 약 15.75 GB/s |
| PCIe 4.x | 16.0 GT/s | 128b/130b | 약 1.969 GB/s | 약 31.5 GB/s |
| PCIe 5.x | 32.0 GT/s | 128b/130b | 약 3.938 GB/s | 약 63 GB/s |
| PCIe 6.x | 64.0 GT/s | PAM4·FLIT | 원시 8 GB/s | 원시 128 GB/s |
| PCIe 7.x | 128.0 GT/s | PAM4·FLIT | 원시 16 GB/s | 원시 256 GB/s |
PCI-SIG는 PCIe 6.0 x16의 최대 양방향 대역폭을 256 GB/s로 설명한다. 이 수치는 송신과 수신 두 방향을 합친 것이므로 한 방향 처리량으로 읽으면 안 된다. PCIe 6.0은 네 전압 레벨로 심볼당 2비트를 전달하는 PAM4를 사용한다. 여기에 고정 크기 FLIT, 순방향 오류 정정(FEC), CRC를 더해 전송 단위와 오류 처리 방식을 함께 바꿨다.
하위 호환과 실제 동작
새 세대 슬롯에 구형 카드를 꽂으면 대체로 양쪽이 함께 지원하는 세대와 링크 폭으로 내려가 동작한다. 다만 이 하위 호환이 물리 장착과 링크 훈련이 가능하다는 뜻일 뿐, 모든 펌웨어·전원·Option ROM 조합이 함께 동작함을 보장하지는 않는다. 라이저나 긴 기판 배선을 거치면 신호 여유가 줄어들 수 있다. 여유가 부족하면 링크가 낮은 세대로 떨어지거나 전송 중 오류가 생길 수 있다.
GPU 작업은 VRAM 안에서 처리하거나 GPU 내부 연산이 오래 걸리는 경우가 많아, 링크 폭보다 이쪽이 병목이 되기 쉽다. 그러나 VRAM 용량을 넘는 데이터를 주고받거나 PCIe 경로에 의존하는 연산이 있으면 링크의 영향이 커진다. NVMe SSD는 보통 x4 링크를 쓴다. 여러 SSD가 칩셋 업링크를 함께 거치면 개별 링크의 합이 플랫폼 경로가 받을 수 있는 폭보다 커질 수 있고, 그때는 공유 경로가 병목이 된다.
트랜잭션과 실제 처리량
CPU나 장치는 메모리 읽기·쓰기 요청을 Transaction Layer Packet(TLP)으로 보낸다. 읽기는 요청 이후 Completion이 돌아오는 왕복 경로를 포함하고, 쓰기는 전송 크기와 동시 요청 수에 따라 링크 활용률이 달라진다. 따라서 작은 요청 하나의 지연시간과 큰 블록을 연속 전송하는 GB/s는 다른 성능 지표다. 링크 계층의 오류 검출과 재전송은 데이터 신뢰성을 높이지만 오류가 반복되면 처리량과 지연시간에 영향을 준다.
PCIe 7.0은 2025년 6월 11일 회원사에 공개되었다. 128GT/s와 x16 양방향 합계 최대 512GB/s를 정의하지만, 규격 공개와 소비자 메인보드·GPU·SSD의 채택 시점은 별개다. PCIe 7.0 규격이 존재한다는 사실만으로 현재 사용하는 슬롯의 속도가 달라지지는 않는다. 링크 상태는 양 끝 장치와 실제 보드 배선으로 정해진다.
참고 링크
- PCI-SIG — PCIe 7.0 전송률과 양방향 대역폭
- PCI-SIG — PCIe 7.0 정식 공개
- PCI-SIG, PCI Express 6.0 Specification
- PCI-SIG, The Evolution of the PCI Express Specification
같이 보기: PCIe Lane과 링크 폭, PCIe Bifurcation, 신호무결성